新语音识别模型上线:英文术语识别准确率提升至 96%
一句话总结
面试精灵新增精英版语音识别大模型:
- 准确率:真人 142 段评测,英文技术术语召回率 96.2%,明显高于中文强化版 58.0% 与专业版 69.7% 。另外精英版相比于专业版,识别幻觉率(噪声/静音误识别出句子)大幅降低,进一步提高实际使用中识别准确率;
- 延迟:首字响应约 0.6 秒(三款中最快),句尾结果约 1.7 秒(中等);
- 成本:8 元/小时,比中文强化版/专业版的 5 元/小时高约 3 元/小时。
如果你参加的是中英混杂的技术面试、英文面试,或问题里经常出现 Java、Spring Boot、Kafka、Redis、Docker、Kubernetes、Transformer、RAG 这类英文术语,精英版是目前最稳的选择。
为什么再上一个语音识别模型
技术面试的语音识别有两个难点:
- 中英混杂:一句话里同时有中文和英文术语,识别系统容易把 “bug” 听成”巴嘎”、把 “k8s” 听成”开巴士”;
- 术语密集:面试官连续报出框架名、组件名、算法名,一处听错就可能让后续回答跑偏。
此前中文强化版擅长纯中文,专业版(大语音识别模型)覆盖多语种,但在英文技术术语上仍有明显缺口。新上线的语音识别大模型对中英混合与英文术语的建模更完整,因此我们把它作为「精英版」上线。
三款模型能力速览
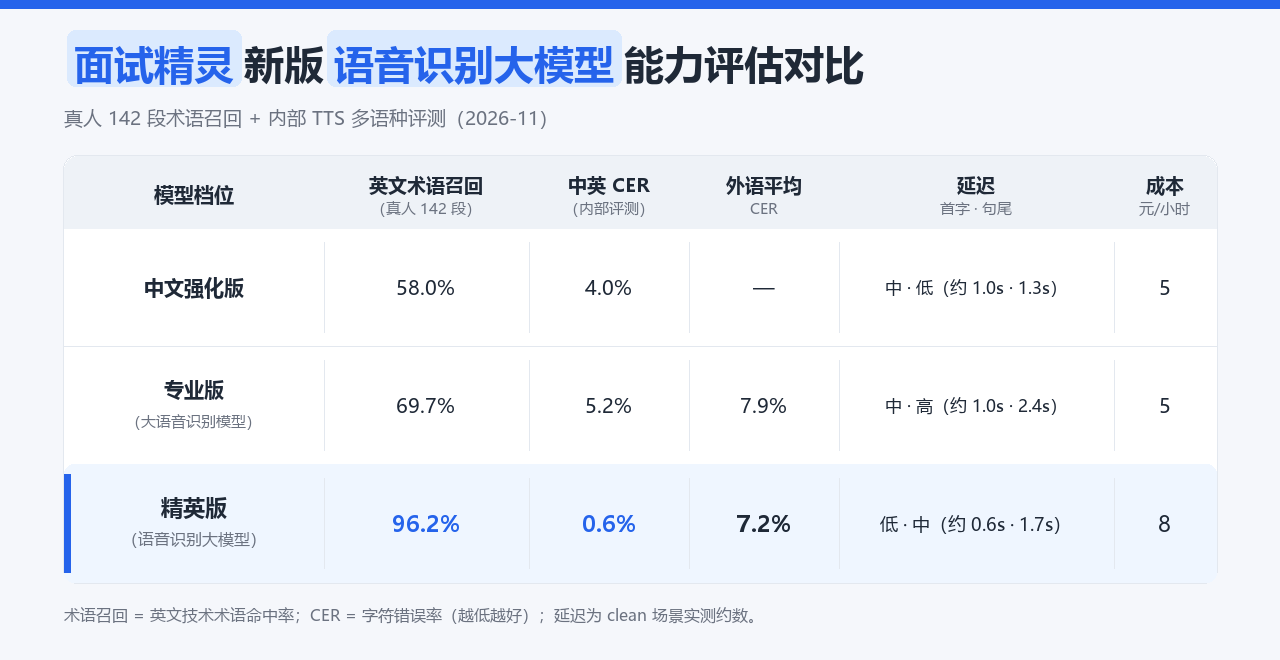
| 模型档位 | 英文术语召回(真人 142 段) | 中英 CER(内部评测) | 外语平均 CER | 延迟(首字 / 句尾) | 成本 | 适合场景 |
|---|---|---|---|---|---|---|
| 中文强化版 | 58.0% | 4.0% | — | 中 / 低(约 1.0s / 1.3s) | 5 元/小时 | 纯中文面试、预算敏感 |
| 专业版(大语音识别模型) | 69.7% | 5.2% | 7.9% | 中 / 高(约 1.0s / 2.4s) | 5 元/小时 | 多外语面试 |
| 精英版(语音识别大模型) | 96.2% | 0.6% | 7.2% | 低 / 中(约 0.6s / 1.7s) | 8 元/小时 | 中英混合、英文术语密集、英文面试 |
CER = 字符错误率,均为越低越好。延迟为 clean 场景实测约数,实际会随网络、音频源与句子长度波动。
英文技术术语:58.0% → 96.2%
真人评测使用 142 段真实面试录音,统计 Java、Spring Boot、Kafka、Redis、Docker、Kubernetes、Transformer、BERT、RAG、MySQL、HTTP API、gRPC、CPU、GPU、Python 等英文技术术语是否被正确识别。
- 中文强化版:58.0%
- 专业版:69.7%
- 精英版:96.2%
相较专业版,精英版多识别出约 26.5 个百分点的术语;相较中文强化版,提升约 38.2 个百分点。术语识别是”听懂问题”的第一步,这一步的收益会直接传导到后续的检索与回答。
中英混合整句:CER 4.0% / 5.2% → 0.6%
内部 TTS 评测对中文与中英混合各 8 句面试题做了整句对比,精英版字符错误率 0.6%,中文强化版 4.0%,专业版 5.2%。
也就是说,整句话里中英文来回切换时,精英版的漏字、错字明显更少。
外语平均:整句 CER 略优,词级 WER 接近
内部 TTS 评测覆盖 8 个外语语种(日语、韩语、德语、法语、西班牙语、意大利语、俄语、波兰语),每个语种 8 句:
| 模型档位 | 外语平均 CER | 外语平均 WER |
|---|---|---|
| 专业版 | 7.9% | 6.6% |
| 精英版 | 7.2% | 7.3% |
- 按字符错误率 CER,精英版 7.2%,略优于专业版的 7.9%;
- 按词错误率 WER,两者接近(7.3% vs 6.6%),专业版略优;
- 个别语种存在差异,例如日语、俄语等场景专业版更稳。建议按你实际面试的语种与口音先小成本试用,再决定档位。
延迟:首字更快,句尾居中
延迟用”首字”(开口后多久出现第一个识别结果)与”句尾”(说完后多久给出最终结果)两个指标衡量:
| 模型档位 | 首字延迟 | 句尾延迟 |
|---|---|---|
| 中文强化版 | 中(约 1.0 秒) | 低(约 1.3 秒) |
| 专业版 | 中(约 1.0 秒) | 高(约 2.4 秒) |
| 精英版 | 低(约 0.6 秒) | 中(约 1.7 秒) |
精英版首字最快,面试官刚开口不久就能看到识别结果;句尾低于专业版,不必等到接近 2.4 秒才拿到完整句子。以上为 clean 场景 4 并发实测约数,真人环境会受网络与设备影响。
成本:8 元/小时
语音识别按下述价格计费,以分钟为单位:
- 中文强化版:5 元/小时
- 专业版:5 元/小时
- 精英版:8 元/小时
以一场 1 小时面试计算,选择精英版比专业版多约 3 元语音识别费用。相对整场面试的大模型 token 消耗,这部分增量占比通常不高,但对高频使用者仍建议按场景选择。更多计费细则见《产品定价》。
怎么选?
- 纯中文面试、预算敏感:选中文强化版,中文识别准确率与精英版基本持平,延迟最低、成本最低;
- 多外语面试:选专业版,成本低,日/俄等语种更稳;如果更在意首字速度,可试精英版;
- 中英混杂、英文术语密集、英文面试:选精英版,英文术语召回 96.2%、中英混合 CER 0.6%,是当前最稳的组合;
- 不确定:先用精英版跑一场真实面试,再对比识别文本与费用,按实际体验调整。
设置路径:面试准备 → 高级面试设置 → 语音识别模型。切换档位后,新发起的识别立即使用对应模型。
体验与反馈
立即体验面试精灵全新语音识别模型 >> interview-genie.com
想了解上一代语音识别升级(多语种与 VAD 优化),可阅读《英文技术词识别率提升 22%》。
遇到问题或想反馈识别效果?加入用户群 ➡️ 联系我们 ⬅️